
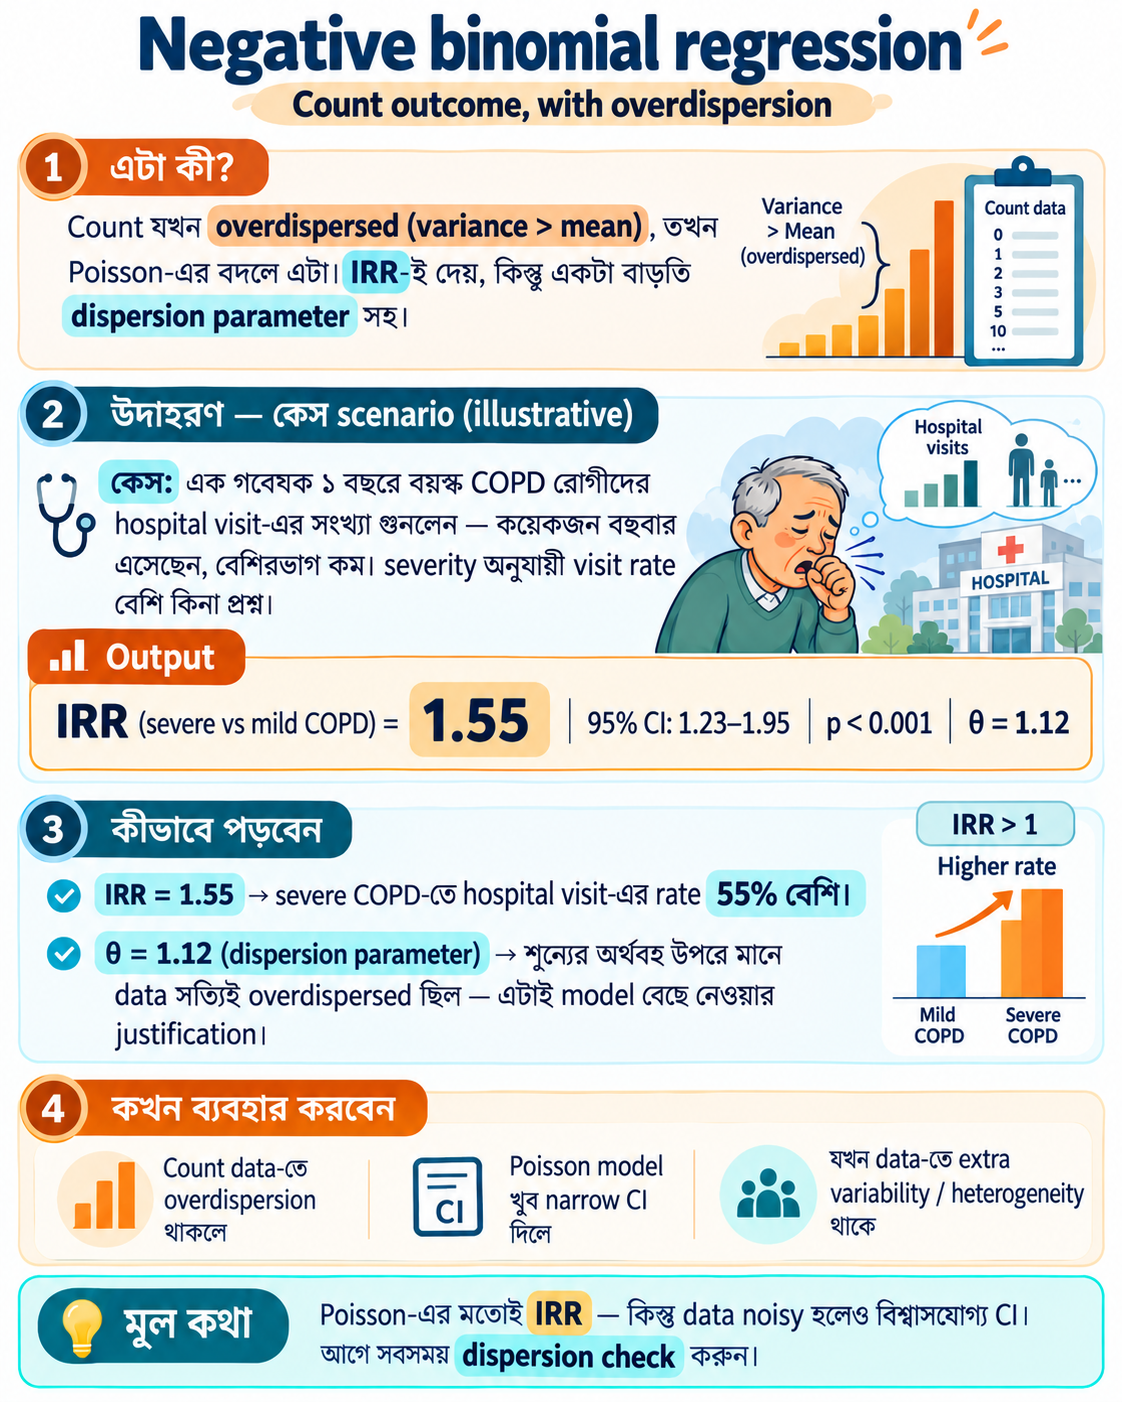
Count যখন overdispersed (variance > mean), তখন Poisson-এর বদলে এটা। IRR-ই দেয়, কিন্তু একটা বাড়তি dispersion parameter সহ।
উদাহরণ — কেস scenario (illustrative)
🩺 কেস: এক গবেষক ১ বছরে বয়স্ক COPD রোগীদের hospital visit-এর সংখ্যা গুনলেন — কয়েকজন বহুবার এসেছেন, বেশিরভাগ কম। severity অনুযায়ী visit rate বেশি কিনা প্রশ্ন।
• Output: IRR (severe vs mild COPD) = 1.55 | 95% CI: 1.23–1.95 | p < 0.001 | θ = 1.12
কীভাবে পড়বেন
• IRR = 1.55 → severe COPD-তে hospital visit-এর rate 55% বেশি।
• θ = 1.12 (dispersion parameter) → শূন্যের অর্থবহ উপরে মানে data সত্যিই overdispersed ছিল — এটাই model বেছে নেওয়ার justification।
💡 মূল কথা: Poisson-এর মতোই IRR — কিন্তু data noisy হলেও বিশ্বাসযোগ্য CI। আগে সবসময় dispersion check করুন।